Google випустила ШІ-моделі для синтезу мови Gemini 3.8 Flash TTS, які вміють клонувати голос
24 сентября 2026
Google представила Gemini 3.8 Flash TTS та Gemini 3.8 Flash-Lite TTS — дві нові моделі синтезу мови, які перетворюють генерацію голосу з набору готових варіантів на більш гнучкий інструмент для створення аудіо. Моделі дозволяють створювати власні голоси, керувати виконанням окремих реплік та генерувати виразні діалоги для ігор, подкастів, аудіокниг та інших проєктів.
Джерело зображень: Google
Gemini 3.8 Flash TTS призначена для створення персонажів та детального управління їх голосами. За допомогою текстових запитів можна задати роль, акцент та характеристики голосу більш ніж для 100 мов і діалектів. У бібліотеці також доступно понад 2000 готових голосів, включаючи регіональні варіанти мексиканського іспанського, квебекського французького та шотландського англійського.
Окремо Google додала можливість клонування голосу за 30-секундною аудіозаписом. Функція призначена для власного голосу або голосу, на використання якого отримано право. Перед створенням копії система перевіряє згоду власника голосу, а отримане аудіо захищається водяним знаком SynthID та метаданими C2PA.
Після вибору голосу розробник може керувати кожною реплікою окремо за допомогою текстових вказівок. Gemini здатна змінювати темп і характер виконання, використовувати шепіт та інші елементи звукової подачі, а також додавати реакції у вигляді сміху, зітхань та коротких реплік.
Обидві моделі підтримують генерацію довгого аудіо з збереженням якості, природного темпу та характеристик голосу протягом кількох годин, а режим двох говорячих дозволяє створювати діалоги з одного сценарію, зберігаючи роздільні голоси та природну черговість реплік. Gemini 3.8 Flash-Lite TTS при цьому розрахована, перш за все, на масштабні проєкти, включаючи дубляж, створення аудіоконтенту та голосових ІІ-агентів.
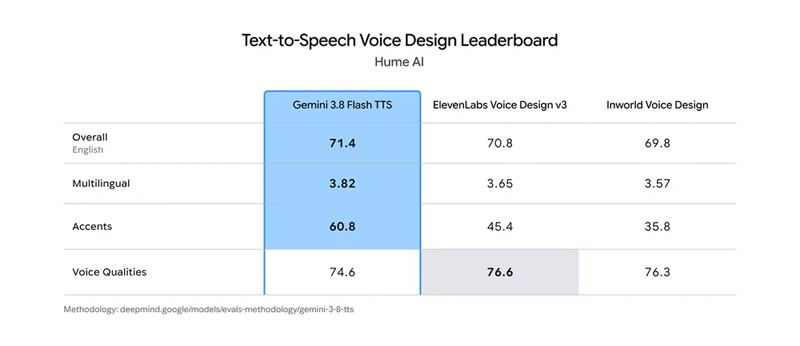
За даними Google, Gemini 3.8 Flash TTS зайняла перше місце в бенчмарку Voice Design компанії Hume AI з результатом 71,4 бала, а в тесті моделювання акценту отримала 60,8 бала. Flash TTS та Flash-Lite TTS також зайняли перше та друге місця відповідно в метриці Overall Quality Index (також від Hume AI). У сліпих оцінках користувачів на Voice Arena моделі показали високі результати в японській, бразильській португальській, в'єтнамській, сучасній стандартній арабській, мексиканській іспанській та хінді.
Нові моделі доступні з сьогоднішнього дня в Google AI Studio, де з'явився окремий інтерфейс для створення голосових сценаріїв. Gemini 3.8 Flash TTS та Flash-Lite TTS також доступні через Gemini API, а їх інтеграцію анонсували платформи Agora, LiveKit, Pipecat та Vercel.
Хочеш дізнатися більше — читай відгуки
← Вернуться на предыдущую страницу
Читайте также:
Попри заборону Трампа Меланія допустила CNN і Politico на свій захід 24 сентября 2026
Перша леді знала про обмеження, а рішення щодо допуску журналістів на її захід ухвалював безпосередньо її офіс, зазначають журналісти.
Тейлор Свіфт влаштувала вихід на біс: замість одного синглу — чотири нові пісні 24 сентября 2026
Спершу в Instagram Тейлор Свіфт з’явилися дивні нулі замість літер. Потім її сайт змінив колір і запустив зворотний відлік. Коли співачка нарешті назвала
Жакет LITKOVSKA і сережки Guzema: розглядаємо новий образ Олени Зеленської 24 сентября 2026
Жакет LITKOVSKA і сережки Guzema: розглядаємо новий образ Олени Зеленської

 5.0


 0.4
