Nvidia представила відкриту ШІ-модель для розпізнавання 40 мов
29 октября 2026
Компанія Nvidia представила ШІ-модель Nemotron 3.5 Transcribe з відкритими вагами для розпізнавання мови, перекладу та аналізу аудіозаписів. Модель дозволяє обробляти аудіо тривалістю до години. У реліз також увійшли набори даних для навчання та інструменти, що дозволяють адаптувати ШІ до спеціалізованих завдань.
Джерело зображення: Mariia Shalabaieva/Unsplash
Nemotron 3.5 Transcribe розпізнає мову на 40 мовах, перекладає з 31 мови на англійську і назад, а також ідентифікує мовців на 13 мовах. Модель здатна обробляти записи за участю до восьми осіб, включаючи тих, хто перебиває один одного.
За допомогою текстових інструкцій користувач може отримати розшифровку з вказівкою мовців, переклад на іншу мову, короткий виклад рішень, прийнятих під час діалогу, або відповіді на запитання щодо змісту аудіозапису. За необхідності можна передати моделі підказки з технічними термінами, наприклад, назвами ліків.
Загальна кількість параметрів моделі становить 30 млрд, однак під час обробки кожного фрагмента даних активні близько 4 млрд. Завдяки цьому Nemotron 3.5 Transcribe може працювати навіть на одній відеокарті Nvidia, наприклад, на компактній DGX Spark. На флагманській RTX PRO 6000 Blackwell Server Edition модель обробляє 100 годин аудіо менш ніж за три хвилини при використанні формату NVFP4.
У тесті Open ASR Leaderboard на платформі Hugging Face модель зайняла перше місце серед моделей з відкритими вагами зі середньою часткою помилок розпізнавання слів 5,33 %. У тестах незалежного бенчмарка Artificial Analysis показник склав 2,81 %, що близько до результату моделі Mistral Voxtral Small, яка становить 2,77 %, хоча у Mistral активних параметрів приблизно в шість разів більше.
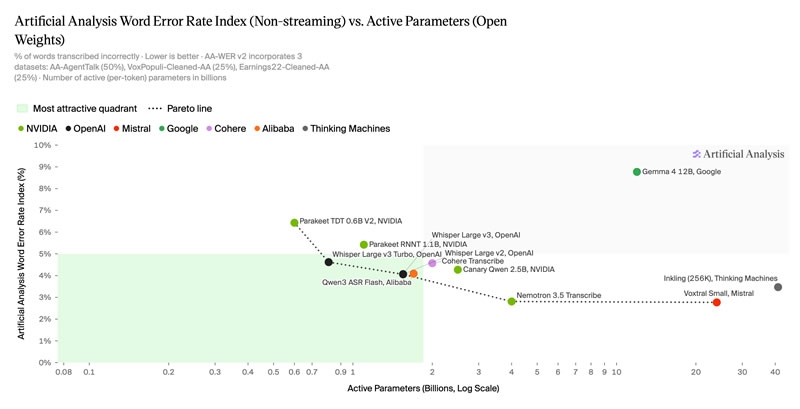
Джерело зображень: huggingface.co
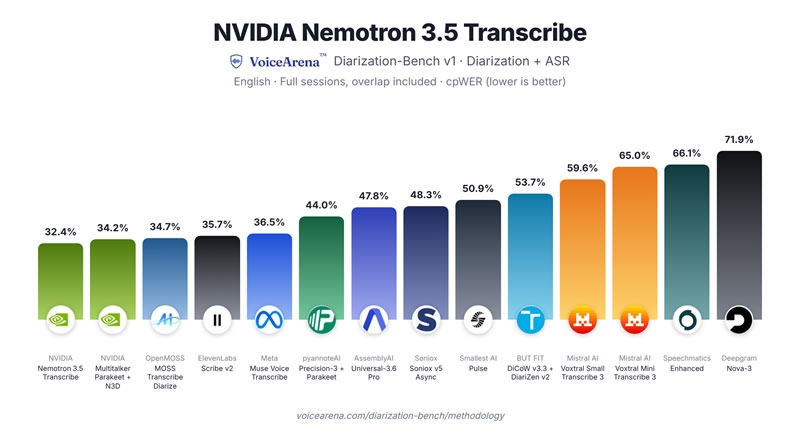
Особливо високі результати Nemotron 3.5 Transcribe показала при визначенні мовців. У тестуванні VoiceArena, що включало 14 систем і записи з одночасною промовою кількох учасників, модель зайняла перше місце. Частка пропущених слів склала 8,32 % проти медіанного значення близько 31 % у учасників порівняння.
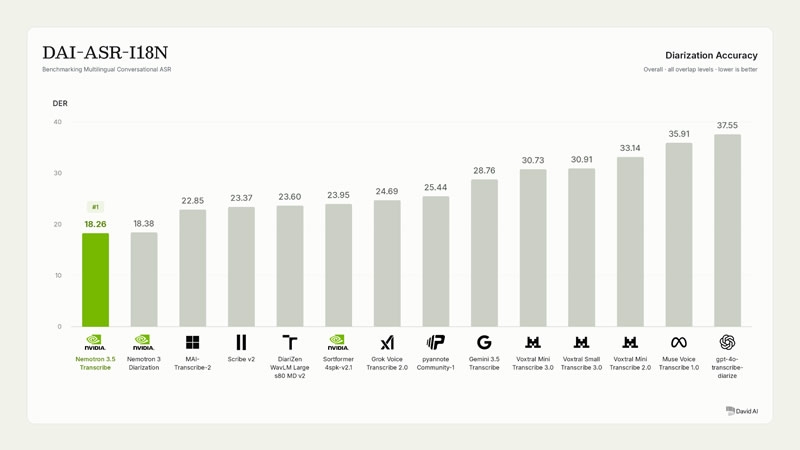
У тесті David AI, що оцінює точність визначення мовців на 21 мові, модель також показала найкращий результат, трохи випередивши спеціалізовану Nemotron 3 Diarization.
Одночасно Nvidia представила набір даних Granary v2, що включає близько 844 тисяч годин аудіозаписів на 48 мовах. Для порівняння: попередня версія містила приблизно 643 тисячі годин мови на 25 мовах. Записи представлені в кількох варіантах розшифровки: дослівному, що зберігає слова-паразити, і з записом чисел словами.
Nvidia також додала в реліз інструменти для підготовки наборів даних. Їх можна використовувати для адаптації моделі до конкретних областей. Наприклад, при донавчанні на медичних записах за участю індійських лікарів і студентів-медиків частота помилок знизилася з 30,8 до 11,8 %. Для перевірки результатів на нових, незнайомих ІІ-моделі голосах показник зменшився з 22,44 до 12,17 %.
Модель Nemotron 3.5 Transcribe та набір даних Granary v2 доступні на Hugging Face. Nvidia також надає демонстраційну версію та посібник з донавчання, включаючи розширення, що дозволяє доручити відповідний процес ШІ-асистенту для програмування. Можливості моделі різняться в залежності від мови. Крім того, система призначена для обробки готових записів, а не потокового аудіо, тому Nvidia рекомендує додатково перевіряти імена та моменти зміни мовців.
Хочеш дізнатися більше — читай відгуки
← Вернуться на предыдущую страницу
Читайте также:
Красуня-ведуча з України захопила стильними образами в Парижі 29 октября 2026
Відома українська телеведуча, журналістка та модель Олександра Кучеренко опублікувала в Instagram серію стильних фотографій із Парижа.
21 ступінь свободи та 1500 датчиків: Xiaomi розробила кисті рук для роботів-виробничників 29 октября 2026
21 ступінь свободи та 1500 датчиків: Xiaomi розробила кисті рук для роботів-виробничників.
Зіткнення потягів в Іспанії: кількість загиблих зросла до 64 29 октября 2026
Ще близько 80 пасажирів зазнали поранень, приблизно 50 із них перебувають у тяжкому стані. Причини аварії встановлюють.

 1.5
 5.0
