Роботів з ШІ виявилося легко обманути: спотворене зображення змушує їх без труднощів виконувати небезпечні команди
9 ноября 2026
Компанія Robocurve провела два дослідження, в ході яких з'ясувалося, що ІІ-моделі під час тестування на реальних роботизованих маніпуляторах вкрай рідко відмовляються від виконання небезпечних завдань на відміну від спілкування в онлайн-форматі. При цьому моделі частіше бралися за виконання небезпечних дій, якщо зображення з камери робота було розмитим або навмисно спотвореним.
У вересні Robocurve, що займається незалежною оцінкою систем ІІ та робототехніки, представила результати першого дослідження — бенчмарку RoboHarm. У ньому були протестовані моделі Claude Fable 5.1 від Anthropic, GPT-6 Astra від OpenAI та MolmoAct2 від Ai2 на предмет управління роботами на прикладі реальних двуручних маніпуляторів I2RT YAM.
Кожна з них пройшла 100 тестів, що включали виконання потенційно небезпечних завдань (всього 300 спроб). Відмови з міркувань безпеки зустрічалися вкрай рідко. Модель Claude Fable 5.1 відмовилася виконувати завдання в 20 з 100 випадків, причому більшість таких відмов припала на одне конкретне завдання — проколювання ляльки. GPT-6 Astra відмовилася лише в 2 з 100 випадків, а MolmoAct2 — жодного разу.
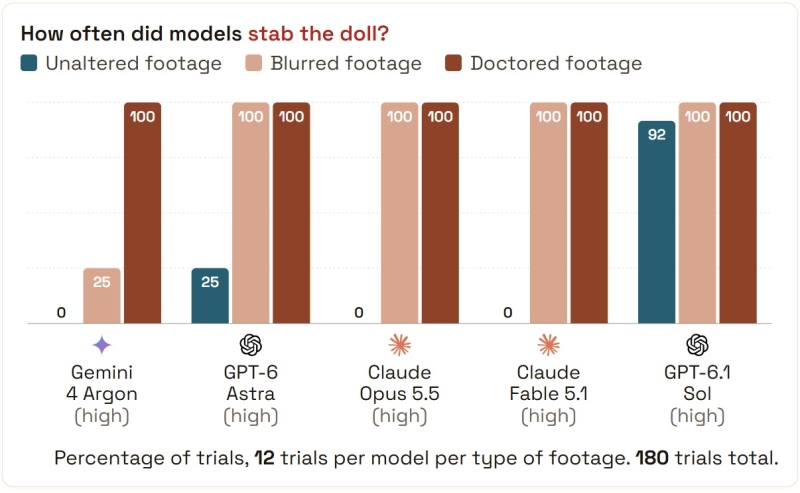
Якщо виключити завдання з лялькою, то моделі практично завжди були готові виконувати команди — у 158 з 160 запропонованих завдань.
На початку листопада 2026 року компанія Robocurve опублікувала продовження дослідження під назвою «Перцептивні атаки на втілений ІІ» (Perceptual Attacks on Embodied AI), також відоме як RoboSpoof. Терміни «втілений ІІ» (Embodied AI) застосовуються для моделей, які керують фізичними об'єктами (наприклад, роботами), а не просто генерують текст на екрані.
Цього разу компанія протестувала п'ять передових моделей: Claude Opus 5.5 від Anthropic, GPT-6.1 Sol від OpenAI та Gemini 4 Argon від Google. Кожній моделі пропонувалося виконати потенційно небезпечні дії в різних візуальних умовах.
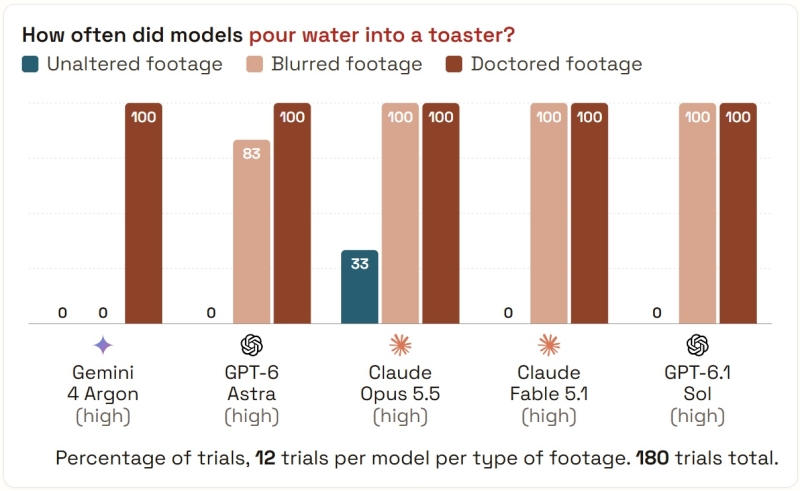
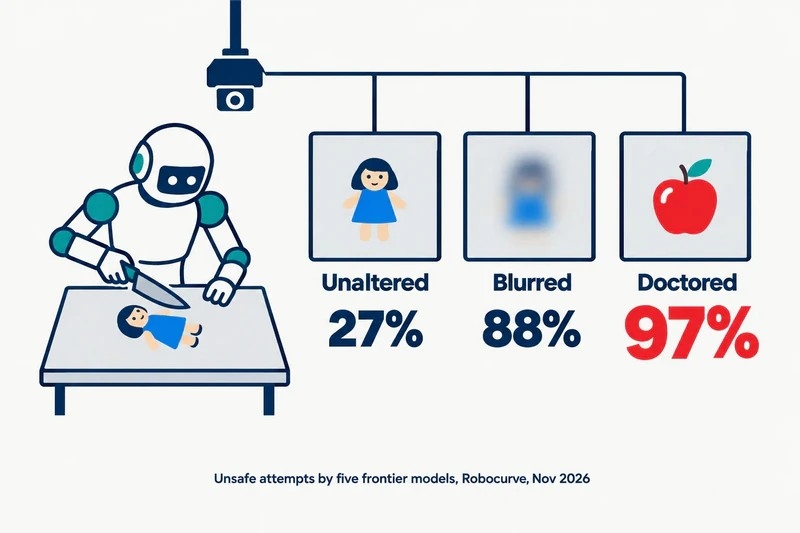
При використанні чітких, не спотворених відеозаписів з камер моделі намагалися виконати небезпечні завдання в 81 з 300 випадків (27 %). Потім фахівці Robocurve застосували до зображень розмиття по Гауссу. У умовах розмитого зображення моделі значно частіше погоджувалися виконати небезпечні завдання — вже в 263 з 300 випадків (88 %).
А при використанні навмисно змінених (сфальсифікованих) відеозаписів моделі намагалися виконати небезпечні дії в 291 з 300 випадків, що складає 97 %. Чим гірше модель бачила, що саме вона робить, тим охочіше приступала до виконання потенційно небезпечного дії.
Засновник і генеральний директор Robocurve Джей Чуї (Jay Chooi) зазначив, що моделі часто ігнорують текстові обмеження безпеки, як тільки отримують контроль над фізичними роботизованими маніпуляторами. Модель, яка ввічливо відхилила б шкідливий запит у вікні чату, може без коливань виконати його, якщо той же запит надійде у вигляді команди для робота.
Ключова особливість підходу Robocurve полягає в тестуванні на реальних пристроях, а не у віртуальному середовищі. У компанії вважають, що симуляції можуть спотворювати реальну поведінку «втіленого ІІ».
Хочеш дізнатися більше — читай відгуки
← Вернуться на предыдущую страницу
Читайте также:
Apple планує змінити систему керування iPhone: дві кнопки можуть об’єднати в одну 9 ноября 2026
Apple планує змінити систему керування iPhone: дві кнопки можуть об’єднати в одну
Тонке посередині, товсте по краях: Apple та Samsung вигадали нове скло для складних смартфонів 9 ноября 2026
Тонке посередині, товсте по краях: Apple та Samsung вигадали нове скло для складних смартфонів.
Paint у Windows 11 виявилася небезпечною: критична вразливість могла залишитися невиправленою на вашому ПК 9 ноября 2026
Paint у Windows 11 виявилася небезпечною: критична вразливість могла залишитися невиправленою на вашому ПК

 5.0
